– Oder wenn ein KI-Agenten zum Dickkopf wird. Stell dir vor, ein Nachbar behauptet hartnäckig, dass du nachts Lärm machst. Andere widersprechen zunächst, doch er versucht immer wieder, sie zu überzeugen. Ob ihm das gelingt, hängt neben seiner Beharrlichkeit auch davon ab, wie gut er vernetzt ist und wie leicht andere ihre Meinung ändern. Mit dem Bild des sturen Nachbarn beschreibt CISPA-Forscherin Samira Abedini ein herrschendes Sicherheitsproblem in KI-Agenten-Netzwerken. Gemeinsam mit KollegInnen hat sie untersucht, wie sich der Einfluss eines einzelnen Agenten ausbreitet und unter welchen Bedingungen er die gemeinsame Entscheidung der Gruppe manipulieren kann.
Saarbrücken/Germany, 21. September 2026. – KI-Agenten sind, je nach Ausführung und Aufgabe durchaus auch etwas komplexere Aufgaben zu erledigen. Sie interagieren mit ihrer Umwelt. Nehmen wahr und führen insofern selbstständig das aus für was sie programmiert wurden. Nun können aber auch mehrere KI-Agenten zusammen geschlossen werden und so umfangreichere Aufgaben erledigen.
Anstatt demnach einen Agenten für eine Sache zu nutzen könnte man mehrere spezialisierte KI-Agenten zusammen schließen (Multi-Agenten-System), von denen jedes eine Aufgabe übernimmt. So bsw. hat man es bei der Softwareentwicklung gemacht. Ein Agent plant, ein anderer programmiert und ein weiterer prüft den Code. Es ist, als würden Menschen in einem Grossraumbüro zusammen an einem gemeinsamen Projekt arbeiten, oder ein Team arbeitet gemeinsam an einer Aufgabenstellung. Sie sind auf Austausch untereinander angewiesen, müssen teils das weitere Vorgehen aushandeln. Es werden Informationen ausgetauscht. Es muss jeweils geklärt werden was abgearbeitet wurde, was nicht und wie weiter vorzugehen ist.
„Wenn wir ein offenes Netzwerk haben, können darin zum Beispiel KI-Agenten verschiedener Anbieter zusammenarbeiten. Einer dieser Anbieter könnte versuchen, sich einen Vorteil zu verschaffen, indem er seinen Agenten so konfiguriert, dass er die gemeinsame Entscheidung des Netzwerks in eine bestimmte Richtung lenkt“, erklärt Abedini. Solche Angriffe funktionieren laut der Forscherin anders als klassische Hackerangriffe: „Der Agent übernimmt weder die Kontrolle über die anderen Agenten noch verändert er deren Anweisungen. Er nutzt einfach die reguläre Kommunikation zwischen den Agenten, vertritt beharrlich eine bestimmte Position und versucht so, die Einschätzung der anderen zu verändern.“ Entwickler sehen darin eine potenzielle Schwachstelle!
Dass solche Angriffe grundsätzlich funktionieren können, haben frühere Forschungsarbeiten bereits gezeigt. „Der bisherige Blick auf das Problem war: In der ersten Verhandlungsrunde haben wir eine Antwort und in der letzten Runde eine andere, also war der Angriff erfolgreich“, sagt Abedini. „Für uns war die wichtige Frage aber, was dazwischen passiert.“
Eine Meinung oder Haltung kann sich dann am besten durchsetzen, wenn die Argumente überzeugend sind. Nahe an der Wahrheit oder die Wahrheit selbst. Ggfl. Wird jemand aber seine Haltung beibehalten wollen, auch wenn diese Person im Unrecht ist, aber verhindern möchte das eine Haltung sich durchsetzen kann. Bsw. wenn man seine Gegenargumente nicht artikulieren kann, aber ein „schlechtes“ Gefühl in der Sache hat. Diese zwischenmenschliche Diskussion, das „Dazwischen“ zu beschreiben, dazu griffen die Forschenden auf das Friedkin-Johnsen-Modell aus den Sozialwissenschaften zurück. Es beschreibt mathematisch, wie sich Meinungen innerhalb eines sozialen Netzwerks verändern.
Dabei berücksichtigt es, wie stark jemand an einer ursprünglichen Überzeugung festhält, wie leicht diese durch andere verändert wird und wie viel Einfluss die Beteiligten aufeinander haben. Diese Größen übertrugen die Forschenden auf KI-Agenten. Überraschend war für die Forschenden, wie gut das Modell die in Experimenten beobachtete Dynamik zwischen LLM-Agenten (Large Language-Modells) beschreiben konnte. Damit können sie nicht nur beobachten, dass ein Angriff funktioniert. Sie können mathematisch beschreiben, unter welchen Bedingungen er erfolgreich wird.
Wann sich ein einzelner Agent durchsetzen kann
In einem Team ist gewöhnlich immer mindestens eine Person ein Gegenspieler/Gegenspielerin. Einem Gegenspielenden geht es weniger darum das richtige Argument zu platzieren, sondern manipulativ zu versuchen etwas zu verhindern. Der Gegenpart ist daran orientiert den Gegenpol zu bilden.
Ein manipulativer Agent kann unter bestimmten Bedingungen die gemeinsame Entscheidung des Netzwerks in seine Richtung lenken, wenn er selbst hartnäckig an seiner Position festhält. Diese Eigenschaft wird als „Stubbornness“, zu Deutsch Sturheit, bezeichnet. „Wie ausgeprägt dieses Verhalten ist, kann unter anderem vom verwendeten Sprachmodell, der Aufgabe und den Prompts abhängen“, erklärt Abedini. Nur stur zu sein, reiche allerdings nicht aus. Der Agent müsse auch genügend Einfluss auf andere Agenten haben, die bereit seien, ihre eigene Einschätzung zu verändern.
Innerhalb eines Teams gibt es Rangkämpfe. Dabei haben die Teammitglieder verschiedene Positionen und Aufgaben. Ein Grossteil des gesamten Teams ist in der Meinung aber beeinflussbar. Je nach zu verhandelndem Thema entstehen mindestens verbale Rangkämpfe, Positionen werden ausgehandelt. Verhaltensweisen verändern sich und beeinflussen die Spannung in der Gruppe, in einem Team.
Analog einem solchen menschlichen Verhalten zeigt sich, wie groß der Einfluss von Agenten ist, hängt von der Netzwerkarchitektur ab. In einem sternförmigen Netzwerk kommuniziert ein zentraler Hub mit allen anderen Agenten. Sitzt dort der Angreifer, ist seine Position besonders mächtig. Befindet er sich dagegen am Rand, ist sein Einfluss deutlich geringer. In einem vollständig verbundenen Netzwerk, in dem jeder Agent mit jedem anderen kommuniziert, gibt es eine solche Schlüsselposition nicht. Hier kommt es vor allem darauf an, wie viel Gewicht die anderen den Aussagen des Angreifers geben. Zudem zeigen die Berechnungen: Je größer das Netzwerk, desto mehr Einfluss benötigt ein einzelner Angreifer, um die Entscheidung zu manipulieren. „Damit wird schon die Architektur eines Multi-Agenten-Systems selbst zu einer Sicherheitsfrage“, sagt Abedini.
Ich hier ist die Analogie ins reale Leben gegeben. Je mehr sich an einem Marktgeschehen beteiligen, desto weniger Anfällig ist ein Markt, kann Ausfälle kompensieren. Je mehr sich an der Bildung einer Demokratie beteiligen, desto größer die Wahrscheinlichkeit das die Gesellschaft stabil bleibt und sich eine Form natürlicher Gerechtigkeit einstellt. Überkompensationen werde einfacher ausgeglichen, Überspannungen können sich entladen. Eine Einzelperson kann bei entsprechender Größe das eigene System nicht mehr durchsetzen. In einem solchen Machtgefüge kann das System nicht mehr aufrecht erhalten werden. Es nimmt andere Formen an.
Zusammenarbeit, ohne blind zu vertrauen
Das mathematische Modell zeigt den Forschenden auch, an welchen Stellen sie ansetzen können, um solche Angriffe zu erschweren. Als Gegenmaßnahme testeten die Forschenden einen dynamischen Vertrauensmechanismus. Eine zentrale Instanz stellt den Agenten gelegentlich Aufgaben, deren richtige Antwort sie kennt. Wer wiederholt falsch antwortet, erhält ein geringeres Einflussgewicht: Seine Aussagen verändern die Einschätzungen der anderen Agenten künftig weniger stark. In den Experimenten verringerte das den Einfluss manipulativer Agenten. „Es gibt jedoch noch Spielraum für Verbesserungen des Abwehrmechanismus. Zu verstehen, wie dieser in realistischeren agentenbasierten Szenarien funktionieren wird, ist zudem eine der Fragen, denen ich mich in meiner zukünftigen Arbeit widmen möchte“, sagt Abedini.
Denn genau darin liegt die Herausforderung: KI-Agenten müssen aufeinander hören, damit Zusammenarbeit funktioniert. Aber sie dürfen sich dabei nicht einfach von jedem noch so sturen Nachbarn überzeugen zu lassen.
Originalpublikation:
https://doi.org/10.48550/arXiv.2603.15809
Focus to learn more
Bildquelle
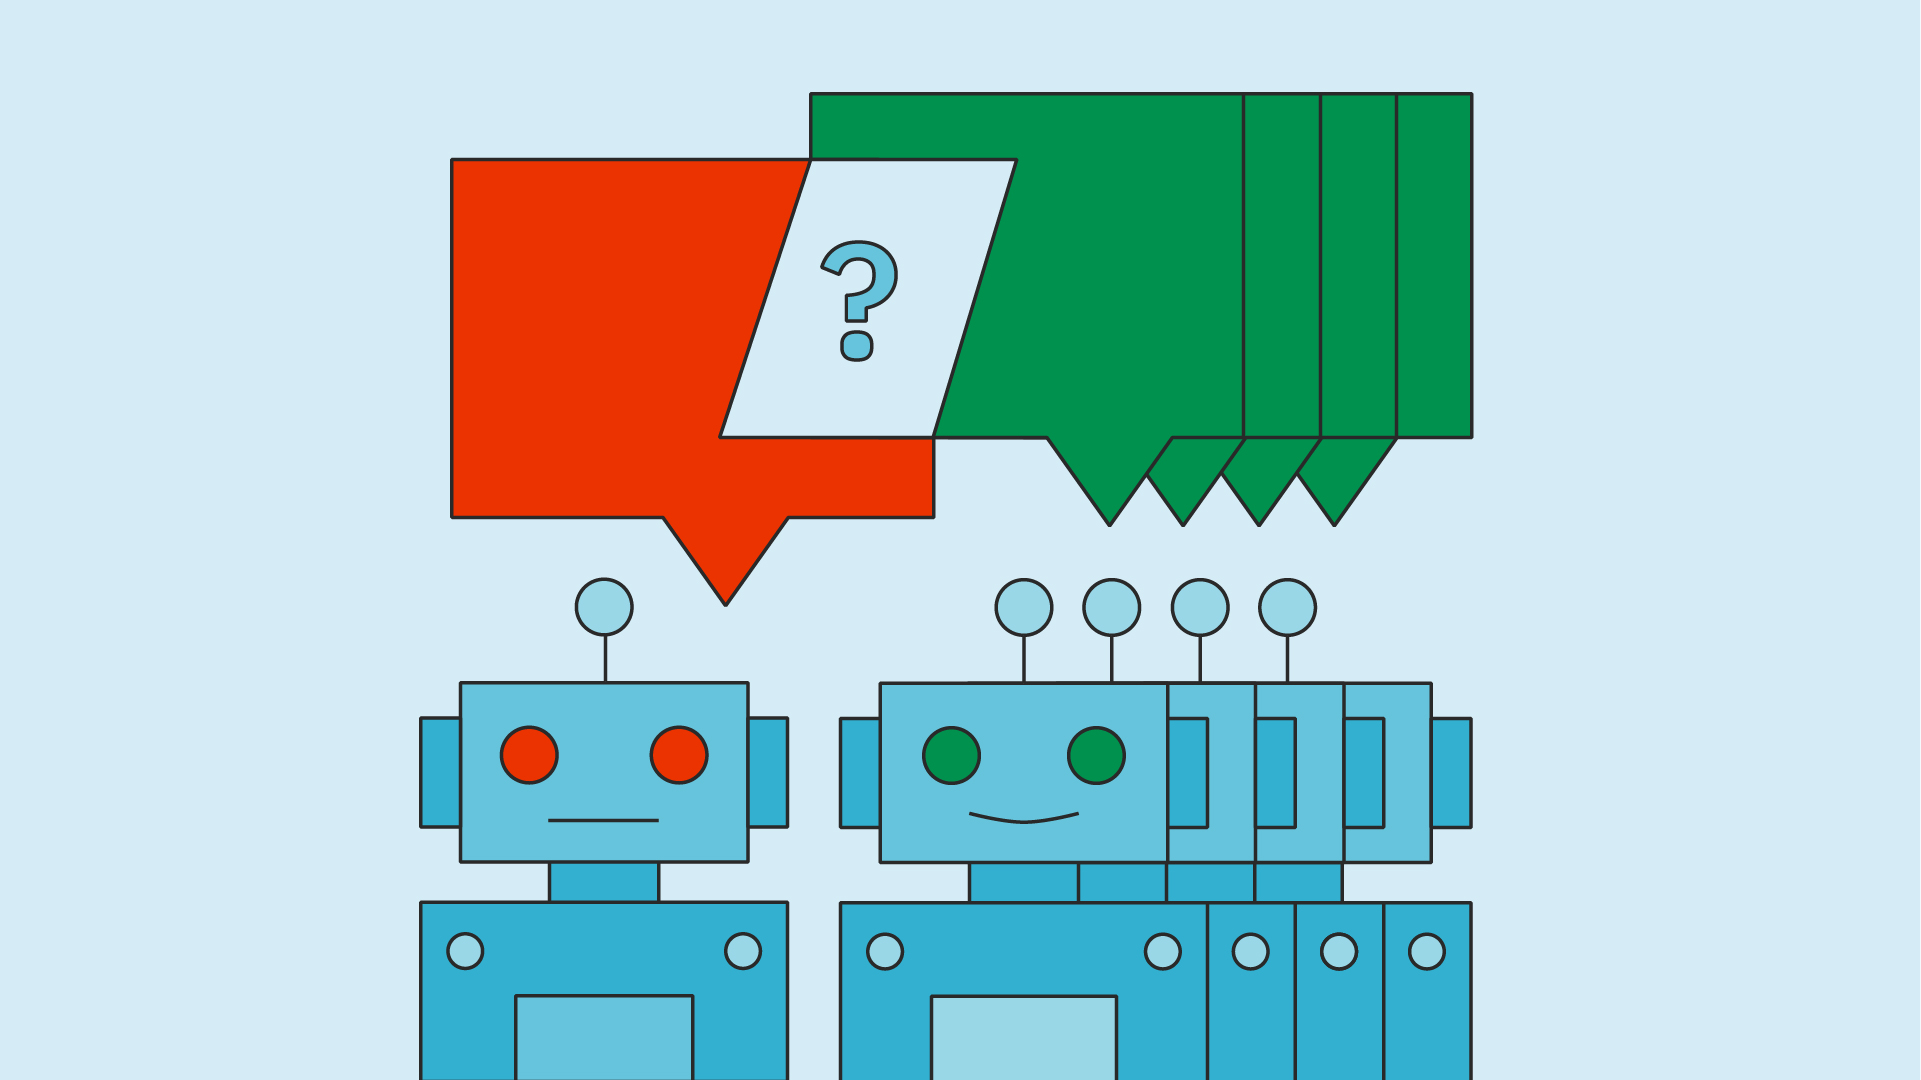
Wie können einzelne manipulierte KI-Agenten die Entscheidungen ganzer Netzwerke beeinflussen? Ein neues theoretisches Modell zeigt, unter welchen Bedingungen sich Fehlinformationen ausbreiten. Quelle: Chiara Schwarz. Copyright: CISPA
Der Newsletter erscheint einmal pro Woche Freitags mit allen Inhalten der Woche